Qwen4-Max resmi dirilis Alibaba pada 16 November 2026 dan langsung memenuhi lini masa para praktisi AI. Model ini berdiri di atas arsitektur Qwen4 dengan tulang punggung 2,4 triliun parameter, kemampuan pengolahan gambar bawaan, serta jendela konteks satu juta token. Bagi siapa pun yang mengikuti arah industri, deretan angka itu bukan sekadar bahan perbandingan di forum, melainkan petunjuk ke mana biaya komputasi akan bergerak sepanjang tahun depan.
Yang membuat rilis ini berbeda bukan klaim kecerdasan, melainkan klaim harga. Alibaba memasarkan Qwen4-Max sebagai rekan kerja yang lebih murah per tugas, bukan sebagai model paling pintar di dunia. Siaran pers resmi menyebut biaya rata-rata per tugas pada benchmark Work360 turun dari 4,43 dolar Amerika menjadi 1,67 dolar, atau sekitar 62 persen lebih hemat dibanding generasi sebelumnya. Angka itulah yang paling banyak dibahas warganet di X, jauh lebih ramai daripada perdebatan skor benchmark.
Spesifikasi Qwen4-Max: 2,4 Triliun Parameter dan Konteks 1 Juta Token
Pengumuman yang dirilis dari Hangzhou itu menyebut model ini sebagai yang paling mumpuni di keluarga Qwen sampai hari ini. Beberapa angka kunci yang tercantum dalam blog resmi Qwen dan siaran pers Alibaba Cloud:
- 2,4 triliun parameter total dengan hanya 71 miliar parameter aktif per token, sekitar 25 persen lebih sedikit dibanding Qwen3.8-Max pada skala yang sama.
- 328 miliar parameter N-gram Embedding tambahan di luar tulang punggung utama, dipakai untuk mengenali pola token lokal.
- Konteks satu juta token plus pemrosesan teks, gambar, dan dokumen dalam satu model yang sama.
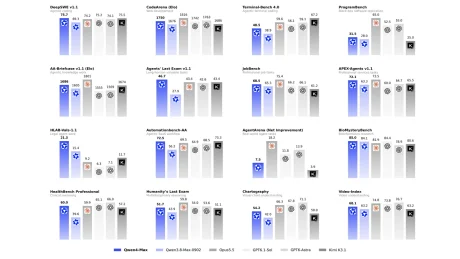
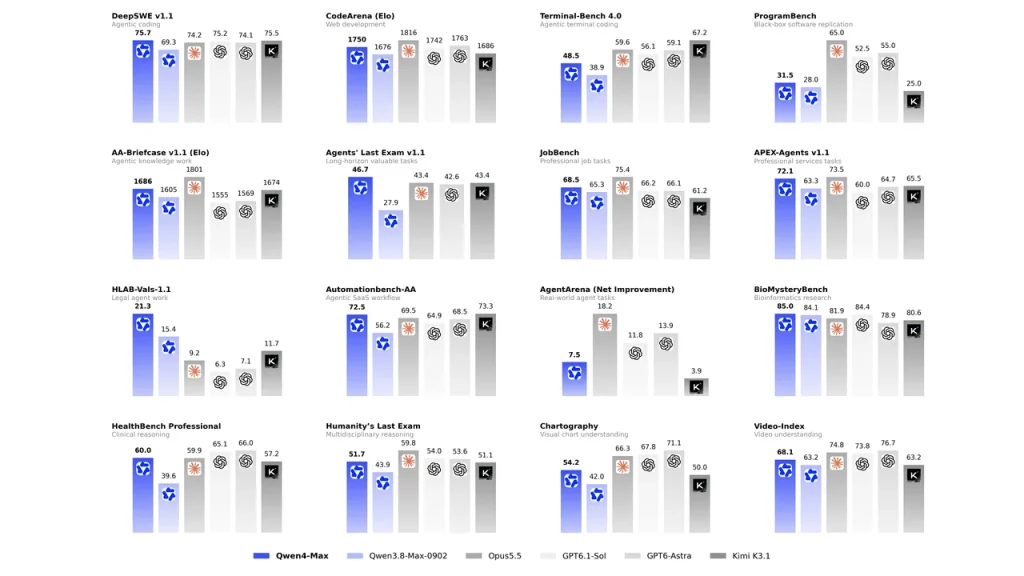
- Skor 1.750 poin Elo di Code Arena, mengungguli Qwen3.8-Max (1.676) dan GPT6.1-Sol (1.742), meski masih di bawah Opus5.5 (1.816).
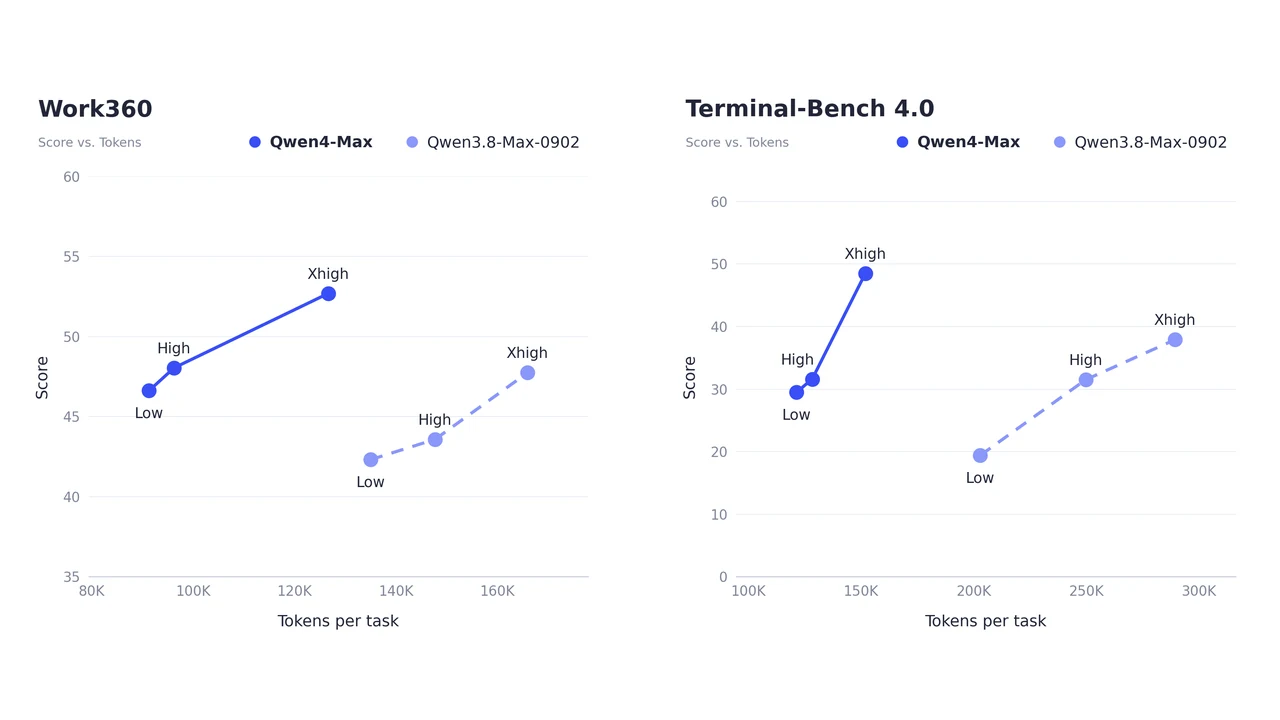
- Skor Work360 52,69, naik dari 47,74 pada generasi sebelumnya, diukur lewat taksonomi 26 domain utama dan 721 bidang kerja khusus.
- Tersedia sekarang melalui QwenCloud dengan skema Token Plan maupun API, serta lewat QwenWork dan QwenStudio di chat.qwen.ai.
Arsitektur Qwen4-Max: Gated DeltaNet, Qwen Sparse Attention, dan Gated Residual
Perubahan paling teknis pada Qwen4-Max terjadi di tiga titik sekaligus: mekanisme attention, koneksi residual, dan embedding. Lapisan Gated DeltaNet memampatkan riwayat percakapan menjadi state berukuran tetap untuk setiap lapisan Qwen Sparse Attention. Attention versi baru itu memakai indexer ringan untuk memilih konteks relevan pada granularitas blok mikro, sehingga biaya attention maupun indexing tetap terkendali ketika percakapan memanjang.
Pada sisi stabilitas pelatihan, empat cabang residual paralel dengan gerbang baca dan tulis dinamis menjaga aliran informasi antar lapisan. Alibaba melaporkan proses pra-pelatihan pada skala 2,4 triliun parameter berjalan mulus tanpa satu pun lonjakan loss. Hasil evaluasi internal di ranah Knowledge, Code, QA, dan STEM juga menunjukkan varian base Qwen4-Max mencatat nilai bits per byte 5 sampai 13 persen lebih rendah dibanding pendahulunya, meski hanya mengaktifkan 25 persen parameter lebih sedikit.
Efisiensi Token Qwen4-Max: Biaya per Tugas Turun 62 Persen
Klaim penghematan itu punya dasar yang bisa diukur. Pada Work360, konsumsi token Qwen4-Max turun sekitar 24 persen di mode penalaran Xhigh dan 35 persen di mode High. Di Terminal-Bench 4.0 penurunannya lebih tajam, masing-masing 48 dan 49 persen. Karena jumlah token lebih sedikit sekaligus harga per token dipangkas, biaya rata-rata per tugas di Work360 anjlok dari 4,43 ke 1,67 dolar. Untuk input yang mengenai cache implisit, tarifnya dipatok 0,075 dolar per satu juta token.
Namun hemat biaya tidak berarti menang di semua arena. Pada Terminal-Bench 4.0, Qwen4-Max mencatat 48,5 sementara Opus5.5 menyentuh 59,6 dan Kimi K3.1 mencapai 67,2. Di ProgramBench jaraknya lebih lebar lagi: 31,5 berbanding 65,0 milik Opus5.5. Pembaca yang terbiasa membaca tabel benchmark pasti menyadari pola ini, dan justru di situ letak cerita yang lebih jujur.
Pola sebaliknya muncul pada tugas jangka panjang dan pekerjaan profesional. Di Agents’ Last Exam, Qwen4-Max mengumpulkan 46,7 dan melampaui Opus5.5 (43,4), GPT6.1-Sol (42,6), maupun Kimi K3.1 (43,4). Pada HLA-B-Vals untuk pekerjaan agen legal, jaraknya paling mencolok: 21,3 berbanding 9,2 milik Opus5.5. Di HealthBench Professional, skornya 60,0, hampir menyamai Opus5.5 di 59,9.
Uji Nyata di Media Sosial: Antusiasme Pengembang dan Suara Skeptis
Pengumuman resmi akun @Alibaba_Qwen pada 16 November mengumpulkan lebih dari 13.800 suka dan 1.490 repost hanya dalam hitungan jam. Akun @QwenDevs menulis bahwa rilis ini membawa “arsitektur baru, vision bawaan, konteks 1 juta, dan cukup banyak perbaikan yang kami tunggu”. Respons paling ramai justru datang dari pengembang yang menantikan versi terbuka.
Akun @HealthRanger menyoroti janji bahwa model open-weight berskala lebih kecil akan dirilis dalam waktu dekat, hal yang selama ini menjadi alasan komunitas bertahan di ekosistem Qwen. Suara berbeda datang dari @RackzHQ yang menyebut tarif output 4,50 dolar per satu juta token dan menilai Qwen4-Max “tidak mengalahkan Fable 5.2 di benchmark”, kendati mengakui biaya per tugasnya lebih masuk akal untuk pekerjaan bervolume besar.
Keluhan lain lebih struktural. @fatma_zaidi1 menulis bahwa model baru kini “turun hampir setiap hari” sehingga menjaga ritme belajar menjadi pekerjaan tersendiri. Bagi pengguna di Indonesia, sindiran itu relevan: nilai seorang praktisi tidak lagi diukur dari seberapa cepat ia mencoba rilis terbaru, melainkan dari kemampuannya menilai model mana yang layak dipakai untuk tugas tertentu dan pada biaya berapa.
Dampak bagi Industri dan Relevansi Kurikulum Praktik di Argia Academy
Bagi industri, langkah Alibaba menandai pergeseran fokus persaingan dari “siapa paling pintar” ke “siapa paling murah per hasil”. Arsitektur Qwen4-Max yang memadukan banyak ahli dengan parameter aktif kecil memungkinkan satu model melayani banyak permintaan tanpa biaya inferensi meledak. Konsekuensinya, penyedia layanan akan semakin sering mengarahkan tugas ringan ke model murah dan menyimpan model besar untuk penalaran panjang.
Implikasi itu terasa langsung di ruang pelatihan. Dalam program pelatihan Argia Academy, peserta tidak berhenti pada mencoba satu tools, tetapi diminta menghitung biaya per tugas, membandingkan keluaran dua model pada kasus yang sama, lalu memutuskan kapan sebuah agen perlu naik ke model besar. Keterampilan itu yang membedakan pengguna biasa dari praktisi yang bisa dipertanggungjawabkan hasilnya.
Permintaan dari segmen korporat bergerak ke arah yang sama. Dalam sesi corporate training, pertanyaan yang muncul bukan lagi “tools apa yang harus dibeli”, melainkan “alur kerja mana yang layak diotomasi dan bagaimana mengukur penghematannya”. Rilis model yang lebih efisien justru memperbesar kebutuhan itu, karena pilihan bertambah dan keputusan teknis jadi semakin bernilai.
Bukti bahwa model ini memang dirancang untuk kerja nyata terlihat dari studi kasus yang dipublikasikan. Di lini produksi otomotif, waktu pemrograman benda kerja manual terpangkas dari sekitar 475 menit menjadi 24 menit, turun 95 persen, karena model melakukan iterasi berbasis umpan balik sebelum proses pemesinan dimulai. Pada riset Alzheimer, Qwen4-Max menjalankan 454 pemanggilan tool dan 3.239 evaluasi metrik untuk menyaring 24 kandidat molekul. Untuk pendingin chip generasi berikutnya, Qwen4 menjalani proses agen 48 jam tanpa henti sampai menemukan molekul coolant yang lolos validasi eksperimen.
“Built as an MoE model with 2.4 trillion total parameters, Qwen4-Max activates only 71 billion per token, 25% fewer activated parameters compared to Qwen3.8-Max at the same 2.4T scale, delivering stronger capabilities at a lower inference cost.”
Siaran pers Alibaba Cloud, 16 November 2026
Pernyataan itu menjelaskan logika di balik seluruh klaim penghematan Qwen4-Max: kapasitas model dibesarkan lewat parameter yang tersimpan, sementara biaya dihitung dari parameter yang benar-benar diaktifkan. Bagi pengguna, dampaknya sederhana, yaitu tagihan yang lebih kecil untuk kualitas keluaran yang setara atau lebih baik.
Akselerasi Kompetensi AI Anda Bersama Argia Academy!
Kuasai pemanfaatan Artificial Intelligence untuk meningkatkan produktivitas kerja, mengembangkan bisnis, dan mempercepat proses produksi konten Anda.
Pelajari pemanfaatan AI untuk:
✓ Meningkatkan produktivitas dan efisiensi kerja
✓ Mendukung pengembangan dan aktivitas bisnis
✓ Mempercepat proses produksi dan ide konten
✓ Mengoptimalkan workflow harian dengan tools AI terkini
Siap Meningkatkan Kemampuan AI Anda?
Konsultasikan jadwal kelas, kurikulum, dan pendaftaran program bersama tim Argia Academy.
Kesimpulan: Persaingan Model Kini Diukur dari Biaya per Hasil
Peluncuran Qwen4-Max menunjukkan bahwa panggung persaingan model bahasa sudah berpindah. Klaim kecerdasan masih penting, tetapi argumen yang paling meyakinkan bagi perusahaan adalah penghematan yang bisa dihitung. Ketika satu tugas yang sama bisa diselesaikan dengan biaya kurang dari separuh, keputusan memilih model berubah dari soal selera menjadi soal anggaran.
Bagi pembaca yang sedang membangun karier di bidang teknologi, pelajaran paling praktis dari rilis ini bukan hafal angka benchmark, melainkan kebiasaan mengukur. Mengetahui kapan cukup memakai model murah, kapan perlu model besar, dan bagaimana membuktikan hasilnya adalah keterampilan yang bisa dilatih sejak sekarang.